-
产品及解决方案
-
服务


-
产品及解决方案
-
服务

-
云原生产品及应用平台
-
云服务
近日,神州数码旗下木犀智能新一代S8630128OPL共封装光学(CPO)液冷数据中心核心交换机在2026云栖大会NVIDIA展台亮相,引发广泛关注。
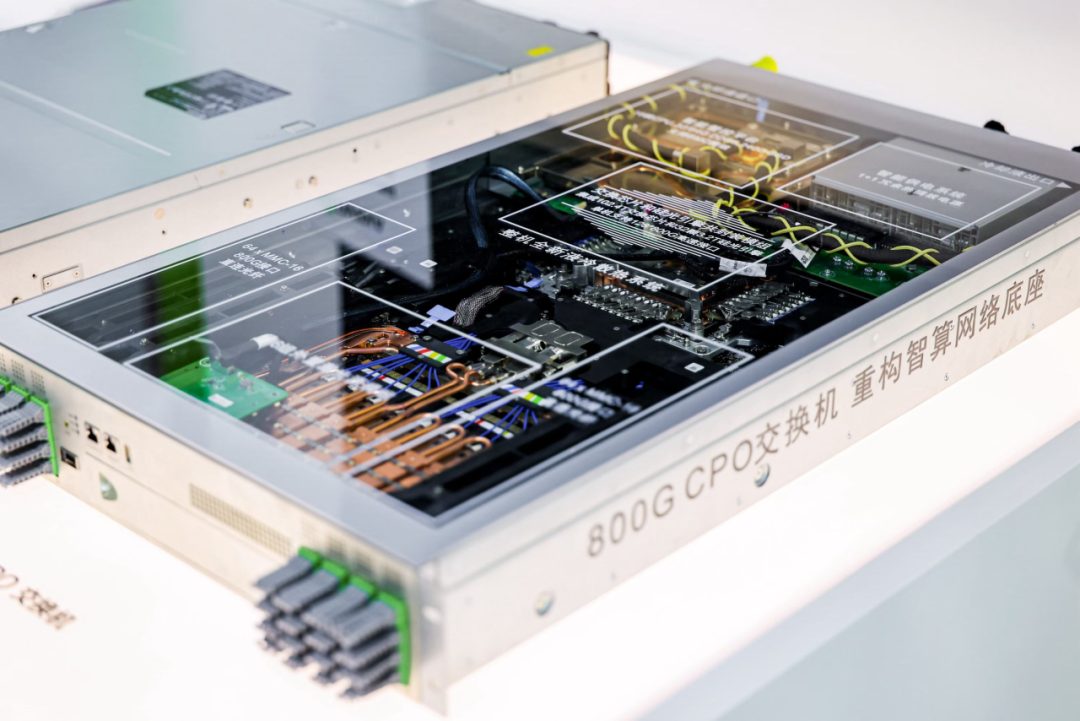
面向大规模GPU算力集群和高速网络互联方案需求,S8630-128OP-L专为AI集群的高性能以太网互联而生,其由单颗NVIDIA Spectrum-6 ASIC驱动,提供102.4Tb/s 交换容量,依托CPO技术实现高效、低时延的单模光纤连接,构筑AI算力集群的核心组网底座。
AI算力爆发 高速互联成为智算关键底座
传统光模块方案,在800G及更高速率组网场景下,面临功耗居高不下、链路损耗增加、机房散热压力陡增等现实痛点。如何在实现超高带宽的同时做到降功耗、提密度、保稳定,已经成为新一代AI智算中心建设必须攻克的关键课题。
在此背景下,CPO技术作为下一代高速互联的核心方向,通过把光引擎(光模块核心)与交换芯片(ASIC)共同封装在同一基板上,尽量缩短高速电信号在板级和封装外部的传输距离,从而大幅减少了高速电信号的传输损耗,实现整机互联功耗下降、转发时延降低,获得更高端口密度,提升链路可靠性,成为支撑大规模GPU集群的重要技术路线。
木犀智能S8630128OPL正是面向这一市场需求打造的CPO液冷核心交换机产品。
CPO+ELS前沿架构革新 重塑高速光互连体验
木犀智能S8630128OPL数据中心核心交换机,采用CPO架构与外部激光光源(ELS)技术,整机液冷散热,将CPO技术前沿突破带入以太网交换平台,把领先的硅光创新直接融入交换设备之中。
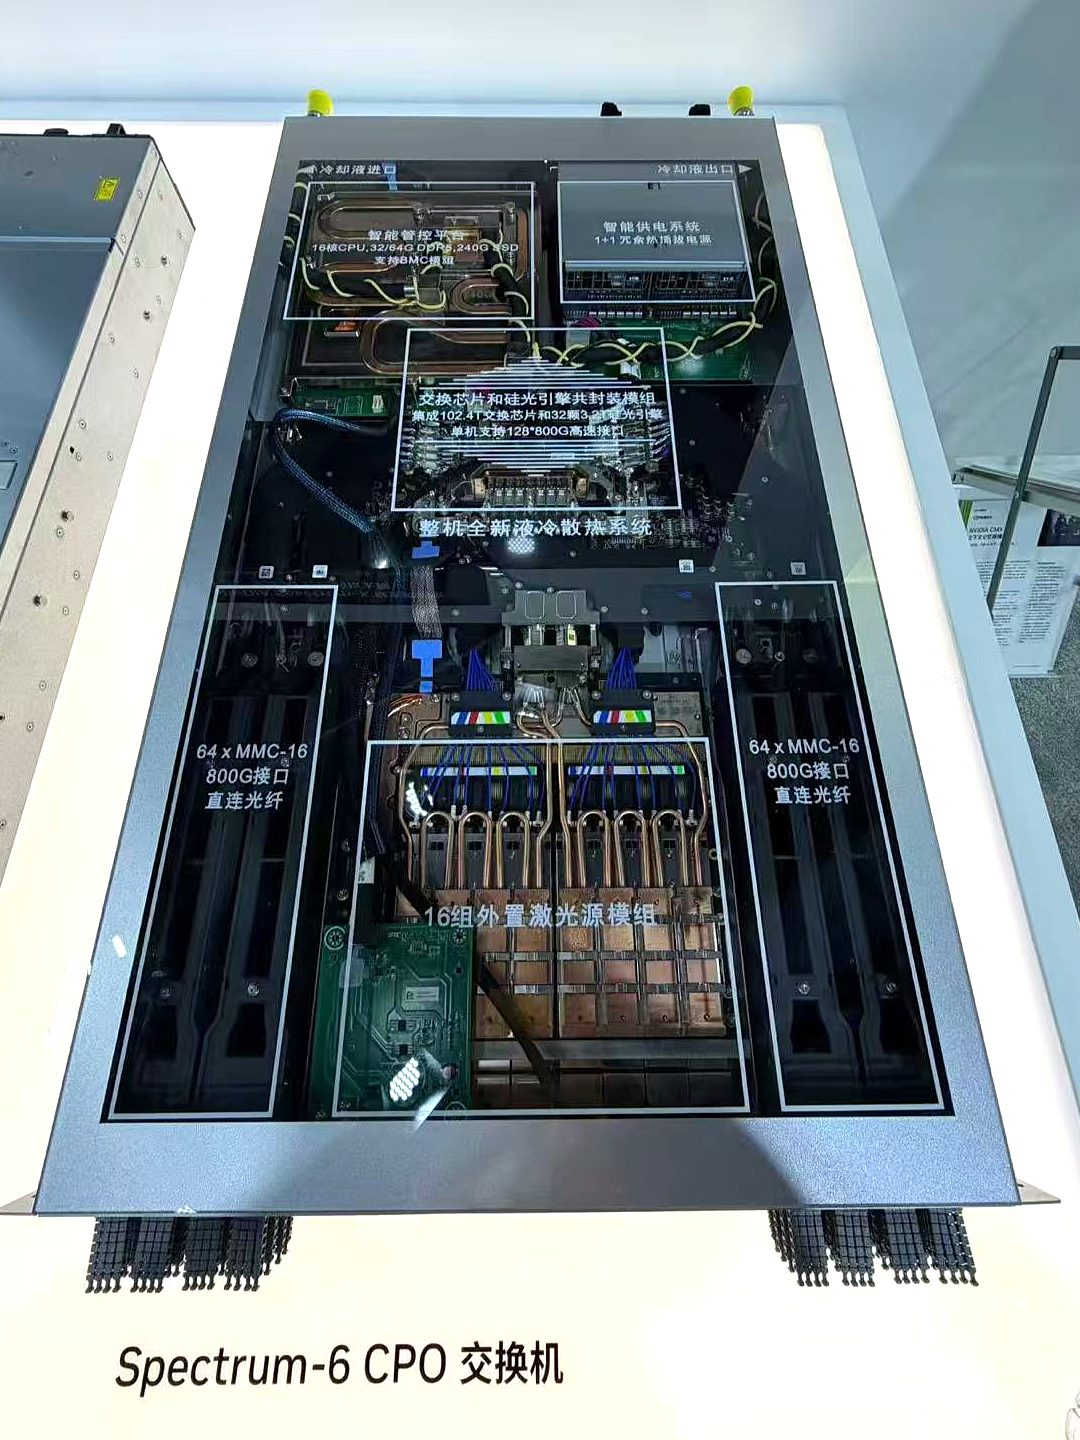
设备由单颗NVIDIA Spectrum-6 ASIC驱动,单机实现102.4Tbps超大交换容量,提供128个800G超高密端口,为大规模GPU集群提供高吞吐、低时延、高可靠的算力互联底座,也为AI应用带来更高能效、更强可靠性与更长不间断运行时间。
这套以太网光互连交换系统,将光引擎与交换ASIC直接集成于同一封装之上,革新传统可插拔光模块架构。内部光路实现光纤直连封装,硅光引擎紧邻ASIC完成光电信号转换;搭配外部激光光源ELS技术,外置光源向集成光引擎持续供光,有效降低芯片封装表面的热聚集,并减少高速链路损耗,显著提升大规模集群部署场景下设备长期运行可靠性。
依托CPO架构先天优势,产品实现多重核心能力:大幅降低整机互联功耗、压缩设备硬件体积(2RU)、实现AI原生无损网络能力、减少链路信号损耗,从底层架构适配AI集群大流量、低时延的业务诉求。
2U液冷高密度设计 适配智算机房严苛环境
面向AI机房高热流密度现实难题,S8630128OPL采用2RU整机液冷设计,业务侧液冷散热,电源模块独立风冷,可高效部署于高密度AI智算机房,解决高密设备散热瓶颈,满足智算中心绿色低碳建设目标。
可靠性层面,交换机搭载1+1可热插拔3200W铂金能效冗余电源,满足7×24小时不间断运行。同时,设备集成完整BMC带外管理能力,配备整机状态指示灯、端口状态指示、UID远程设备定位功能。面对上万台设备的大型智算机房,运维人员可快速完成设备识别、状态巡检、故障定位,有效降低大规模集群运维压力。
软件层面,S8630128OPL既支持木犀智能自研MXNOS操作系统,也兼容行业主流第三方NOS,便于云厂商、智算客户开展定制化网络开发,摆脱软硬件生态绑定。此外,设备端口支持灵活拆分,可向下兼容400G/200G/100G多种速率,兼顾新老设备混合组网的现实需求。
聚焦核心应用场景 赋能智算产业建设
S8630128OPL专为AI集群高性能以太网互联打造,可广泛应用于多重核心业务场景。面向超大规模AIGC大模型训练集群,设备可支撑十万卡级别GPU集群高速互联,保障大模型训练大流量数据高效交互;
在高性能计算HPC以及AI智算中心部署中,它可担当核心交换节点,承接算力集群东西向的大流量转发需求;
对于新建的下一代800G云数据中心,设备也能够很好匹配业务诉求,兼顾高端口密度、低功耗与液冷部署的综合要求。
展会现场,来自云服务商、智算建设方、算力服务商等众多行业观众到访参观,实地了解S8630128OPL硬件形态、CPO技术实现方案、液冷机房部署方案,围绕CPO技术商业化落地、AI集群网络建设、开放网络生态、绿色液冷数据中心建设等热点话题展开深入交流。
面向AI算力高速发展的时代浪潮,木犀智能将持续深耕AI基础设施领域,聚焦数据中心交换机、液冷等技术方向,联合NVIDIA及更多生态合作伙伴,打磨更加贴合行业实际需求的高速互联解决方案,助力AI智算中心降本增效,为大模型产业蓬勃发展筑牢坚实网络根基。


版权所有2016-2026 神州数码集团股份有限公司,保留一切权利。 京ICP备05051615号-1  京公网安备 11010802037792号